一个工程师的深夜工作台:AI 工具实测、效率方法与独立开发手记。
全部文章
-
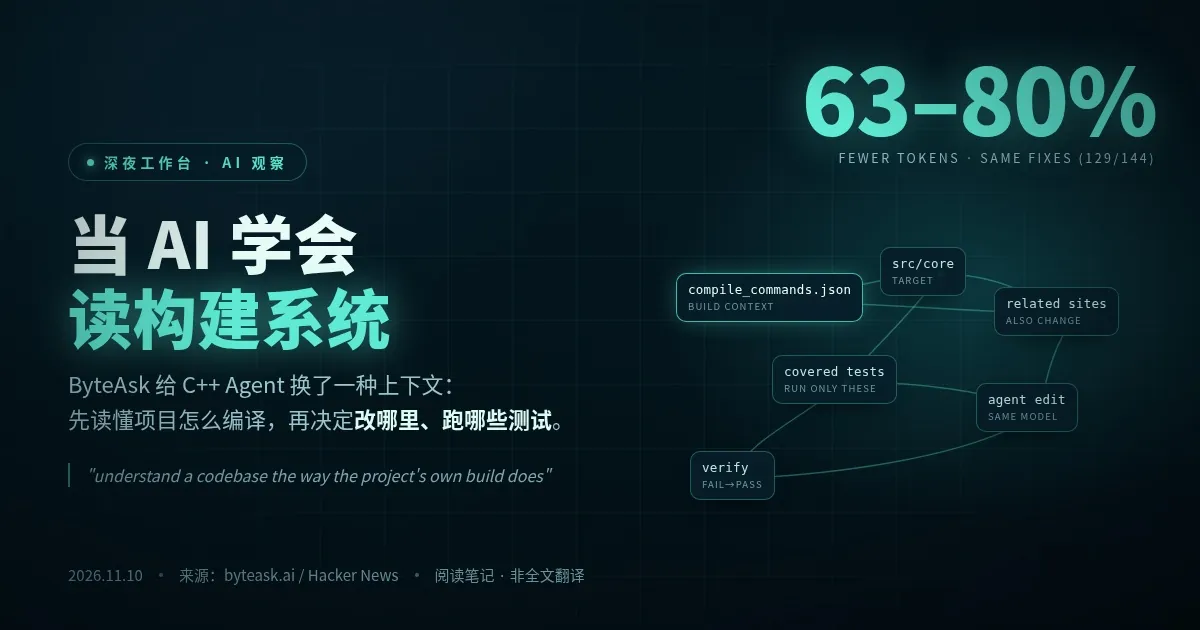
当 AI 学会读构建系统:ByteAsk 给 C++ Agent 的一记提醒
ByteAsk 用"构建感知"的上下文引擎给 C++ 编码 Agent 定位改动与测试,在通过数不变的情况下把 token 用量降了 63% 到 80%。这篇笔记拆它的方法、数据和没说完的部分。
-
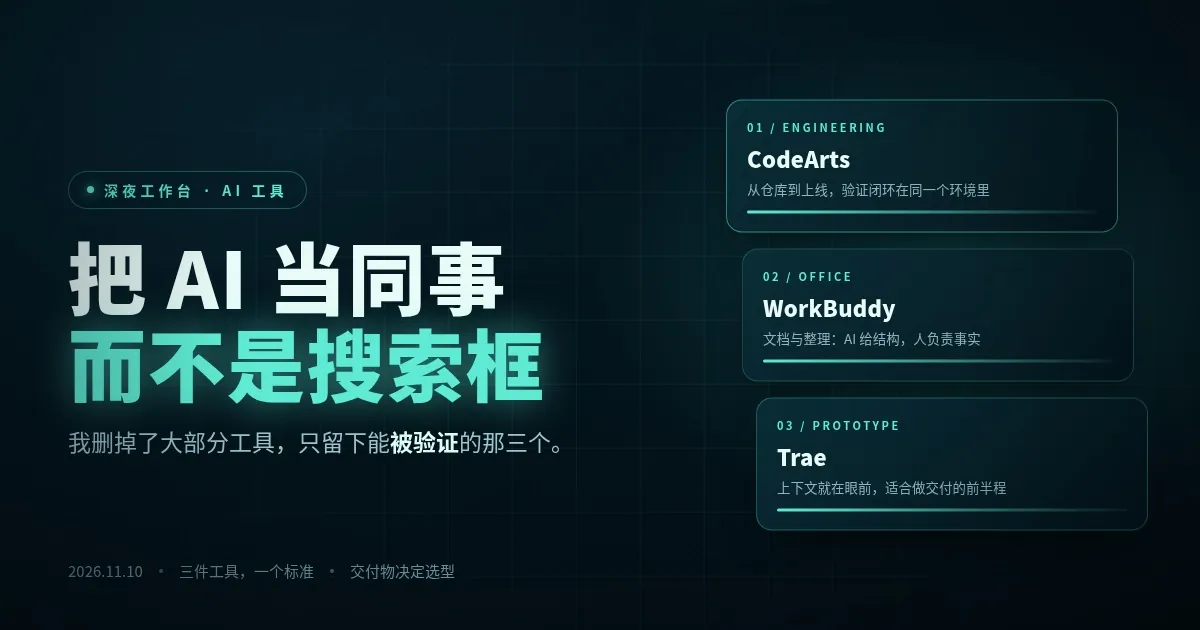
把 AI 当同事,而不是搜索框:我最后留下三件工具
从"交付物能不能被验证"出发,聊 CodeArts、WorkBuddy、Trae 各自适合的场景与真实局限,而不是再排一次榜单。
-
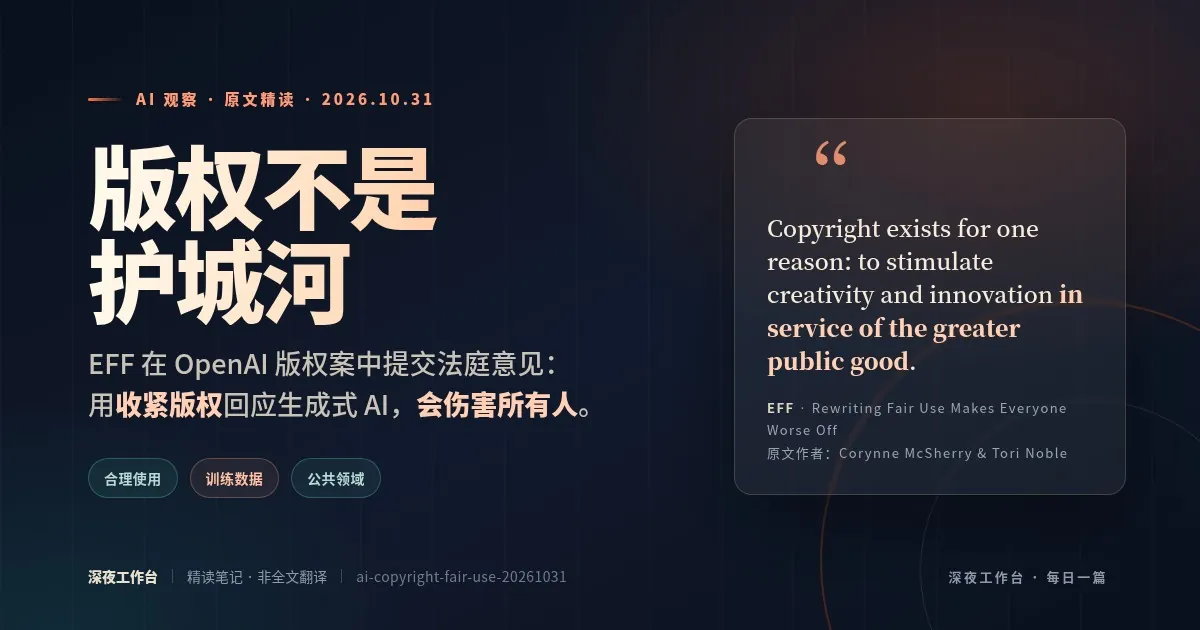
版权不是护城河:读 EFF《重写版权法会伤害所有人》
EFF 在 In re OpenAI 案中提交法庭意见,反对用收紧版权回应生成式 AI。本文梳理其核心论证、摘录关键原句,并给出我的判断与保留意见。
-
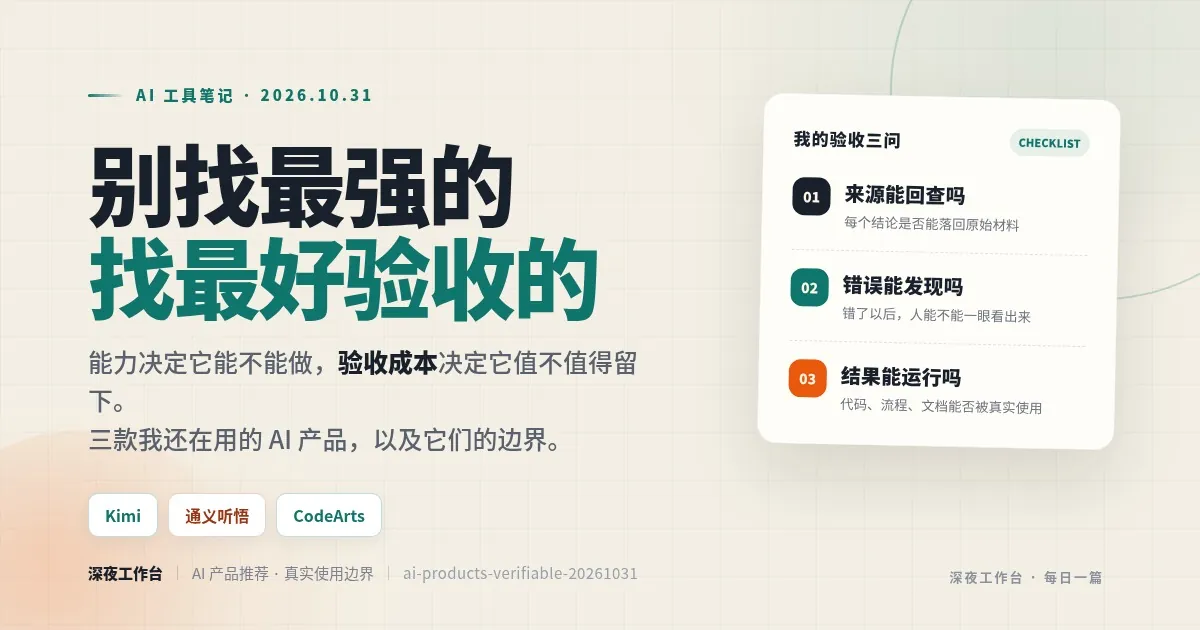
别找最强的 AI,找最好验收的:Kimi、通义听悟、CodeArts 使用笔记
从验收成本出发,聊聊 Kimi、通义听悟、CodeArts 各自适合什么任务、我怎么用,以及哪些事不该交给它们。
-
把一个 CPU 编译进模型权重:Qwenputer 精读
Qwen 3.5 4B 的权重里编译进了一颗 RISC-V CPU,用 Gated DeltaNet 层当 RAM。这篇笔记拆解它的原理、实测数字和作者自己承认的局限。
-
AI 产品别按榜单买:我按任务形状留下三个工具
从任务形状而不是排行榜出发,聊聊 CodeArts、Trae、WorkBuddy 各自适合什么、不适合什么,以及我每天怎么在它们之间交接。
-
精读:AI 搜索的索引、检索与重排——为什么关键词搜索总差一口气
精读 Thinkmill 的 AI 搜索实践:文本搜索、嵌入搜索与 reranker 三层结构各自解决什么问题,为什么召回缺失无法靠重排补救。
-
从补全到协作:CodeArts、WorkBuddy、Trae 三款 AI 编程工具怎么选
不堆参数,只谈场景:CodeArts、WorkBuddy、Trae 三款 AI 编程工具各自适合谁、能解决什么问题,以及在真实工程里必须承认的局限。
-
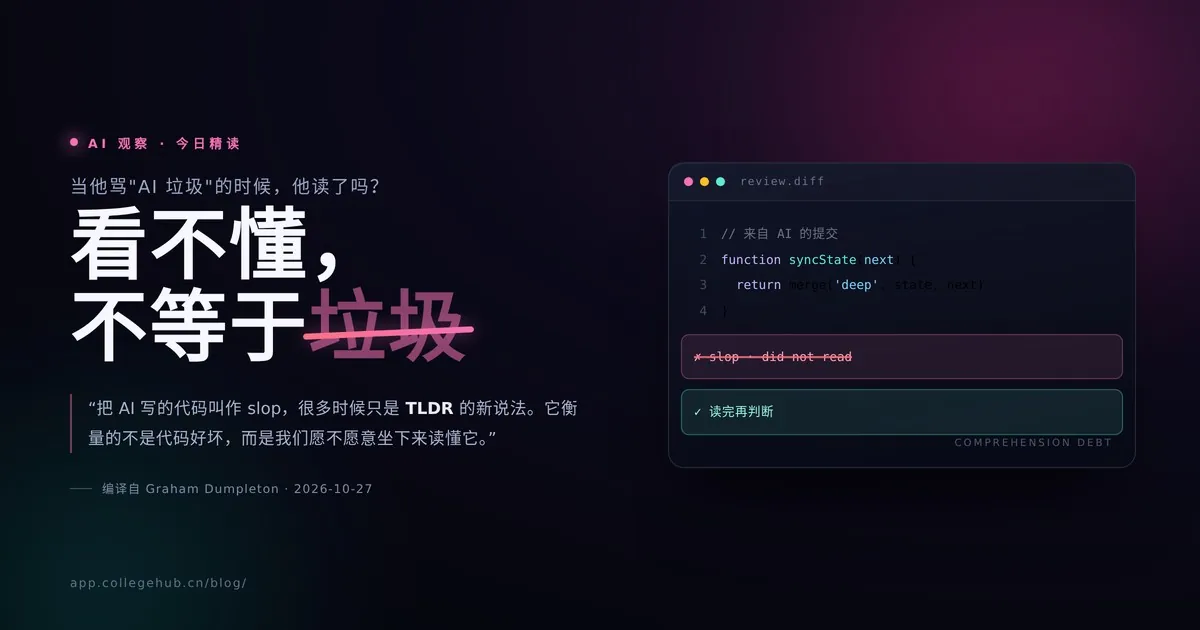
当「看不懂」被叫作「AI 垃圾」
一位 Python 老兵的观察:在骂 AI 代码是 slop 之前,我们往往根本没读。真正的成本不是生成,而是「理解债」——它每天都在悄悄累积。
-
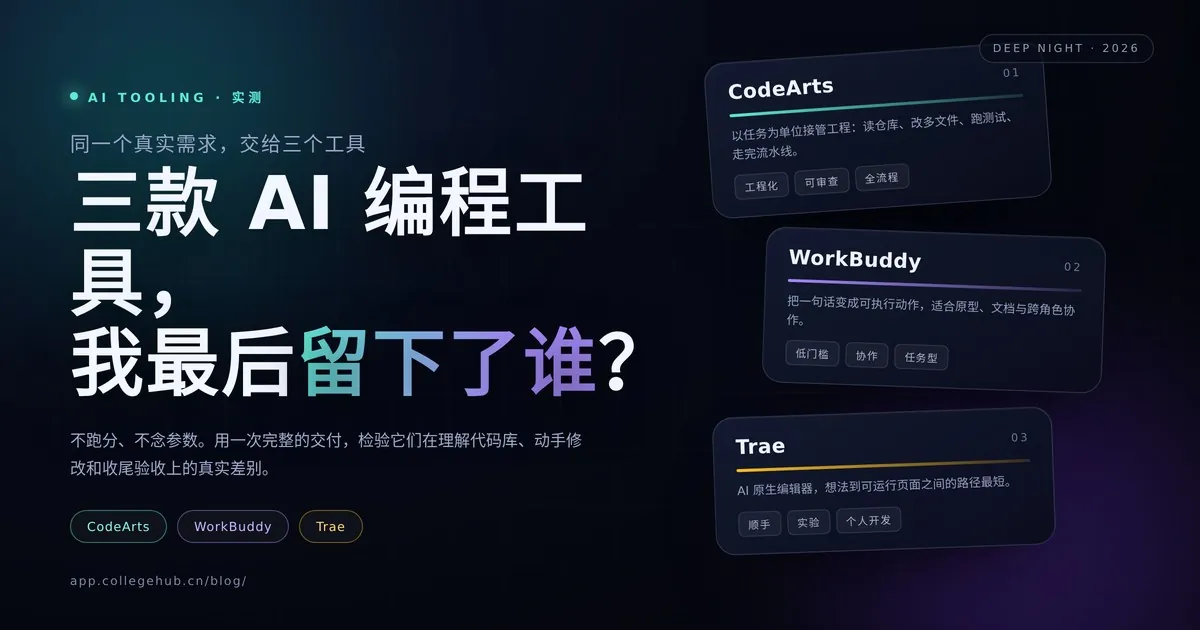
三款 AI 编程工具,我最后留下了谁?
同一个真实需求,分别交给 CodeArts、WorkBuddy 和 Trae。我不看参数表,只看它们能不能把一件事从头做到尾——以及最后,谁被我留在了日常工具栏。